Как получать от ИИ точные ответы по объёмным документам из Яндекс Вики
4 рабочие задачи, в которых Markdown помогает точно анализировать объёмные файлы и собирать документы с готовой вёрсткой.


Содержание
- Быстро найти ответ в инструкциях и регламентах
- Вычислить ошибки в таблицах на сотни строк
- Сравнить версии файла и найти изменения
- Собрать новый документ из нескольких источников
Многие компании ведут базу знаний в Яндекс Вики и используют нейросети, чтобы быстро анализировать объёмные документы. Но при загрузке обычного PDF-файла или скопированного текста структура теряется. Кроме того, расшифровка PDF — это всегда дополнительная нагрузка на модель, на которую уходят лишние токены, время и деньги.
Теперь любую страницу из Вики можно скачать в формате Markdown в один клик. Для нейросетей это «родной» язык — ИИ видит чёткую структуру документа и даёт точные ответы без искажений. Ниже — рабочие сценарии, в которых пригодится выгрузка файлов в Markdown.
Быстро найти ответ в инструкциях и регламентах
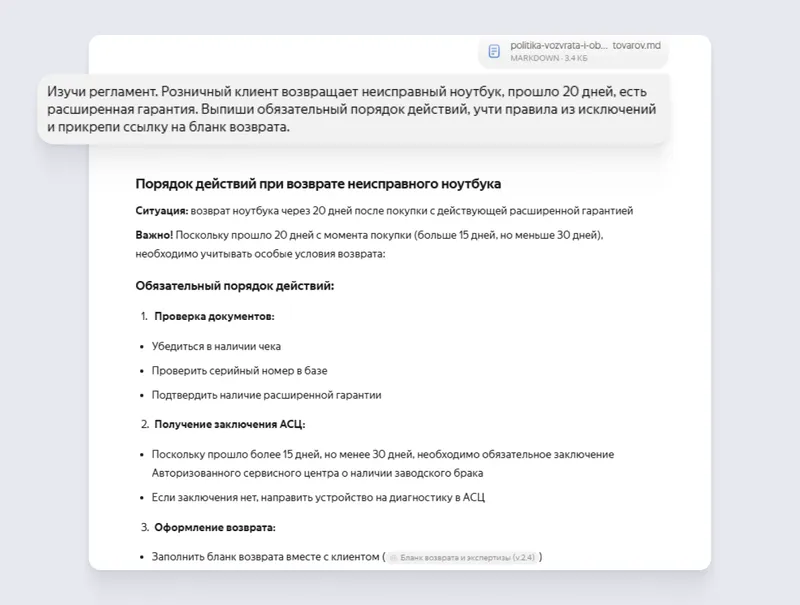
В Яндекс Вики могут хранить объёмные корпоративные правила, в которых нужно быстро ориентироваться. Например, в магазин бытовой техники обратился клиент: он хочет вернуть товар по расширенной гарантии спустя 20 дней после покупки, и сотруднику нужно свериться с регламентом по возвратам. Или HR-специалисту нужно срочно узнать, как по объёмному «Положению о командировках» компенсировать билеты, если сотрудник решил задержаться в другом городе на выходные.
Первый вариант — скопировать текст вручную или выгрузить его в PDF. Однако, если документов несколько и каждый занимает десятки страниц, только на скачивание может уйти 10 минут и более. Кроме того, ИИ получит этот текст как неструктурированный массив слов, из-за чего может перепутать разделы и выдать правила возврата для оптовиков вместо розницы или пропустить важное исключение, которое было выделено жирным шрифтом.
Второй вариант — скачать страницу из Вики в формате Markdown. Процесс займёт меньше минуты, даже если это большой документ на сотню страниц. В Markdown сохраняется структура документа: заголовки, списки и другие элементы форматирования. Это помогает нейросети быстрее находить нужную информацию и меньше галлюцинировать.
Кроме того, Markdown сохраняет все гиперссылки. Если в регламенте зашита ссылка на «Бланк возврата товара» или шаблон «Служебной записки», нейросеть не потеряет её и прикрепит к своему ответу.
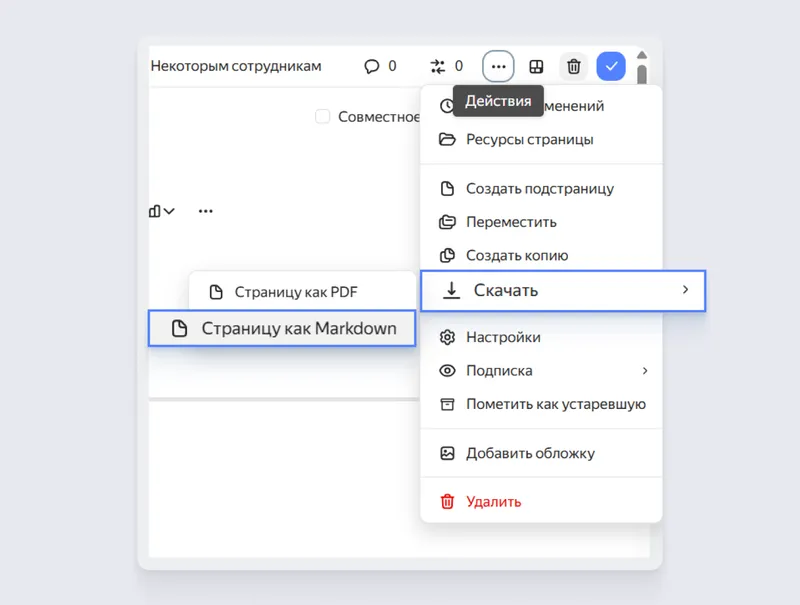
Файл, который вы скачали в формате Markdown, можно использовать как источник знаний для вашего запроса.
Вычислить ошибки в таблицах на сотни строк
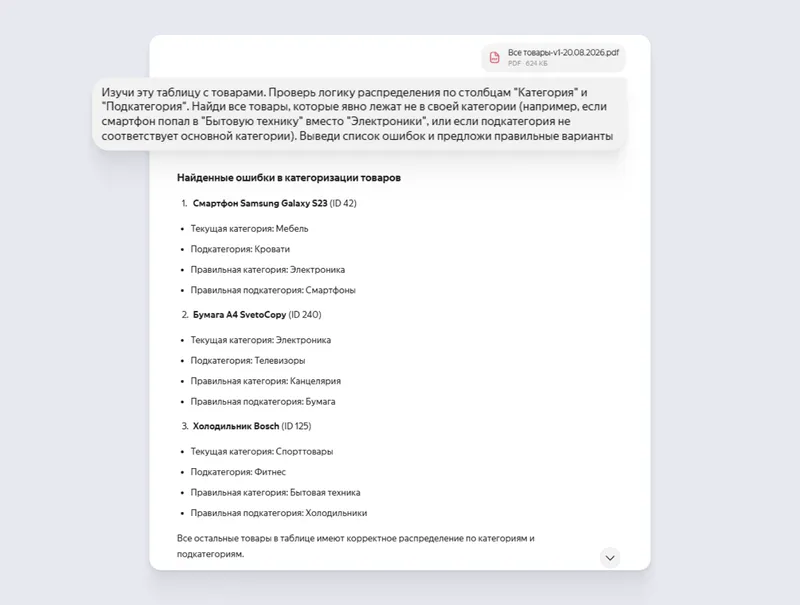
В Яндекс Вики иногда хранят огромные таблицы. Это может быть база товаров компании на сотни строк, которую нужно проанализировать на нестыковки — например, не попал ли по ошибке смартфон в «Бытовую технику». Или может быть матрица доступов сотрудников, где нужно проверить распределение прав.
При выгрузке PDF-таблицы с пустыми ячейками возникает риск сдвига данных из соседних колонок. Из-за этого нейросеть может считать информацию с ошибками: например, принять цену за артикул, а название отдела — за фамилию сотрудника.
Формат Markdown помогает обойти эту проблему. В нём структура таблицы зафиксирована разметкой, поэтому нейросеть получает данные в правильных столбцах. В таких условиях модели проще сопоставить факты и найти логические нестыковки.
Листайте вправо, чтобы посмотреть, как это работает на примере проверки товарной матрицы.
Приятный бонус файлов в Markdown — их вес. Поскольку в Markdown нет тяжёлых встроенных шрифтов и сложного дизайна, огромный прайс-лист вместо 15–20 мегабайт в PDF будет весить всего несколько сотен килобайт. Так вы не превысите лимиты нейросети на размер файла, а сам ответ сгенерируется быстрее.
Сравнить версии файла и найти изменения
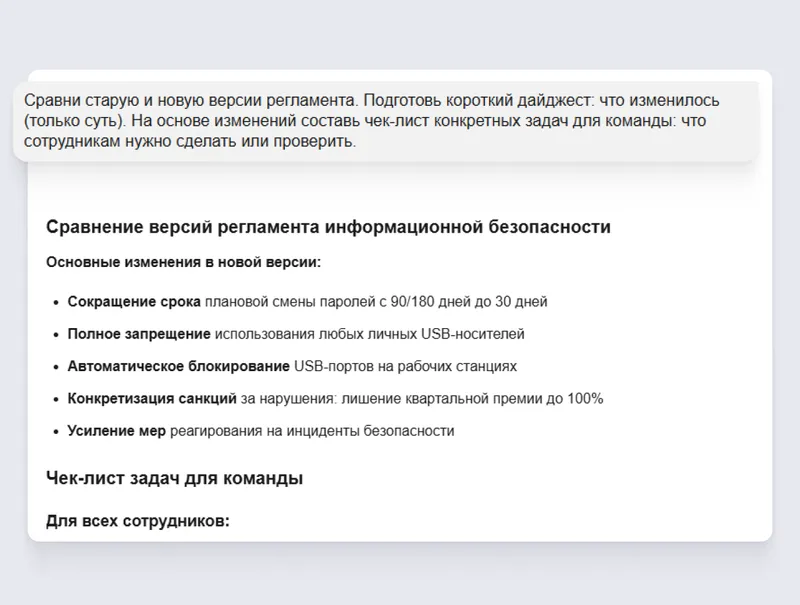
В Яндекс Вики регулярно обновляют внутренние документы на десятки страниц. Это может быть Политика информационной безопасности или типовой договор оказания услуг. Руководителю нужно быстро понять, какие новые требования или штрафы появились в свежей версии, чтобы составить чеклист для команды или предупредить менеджеров.
Чтобы сравнить два объёмных документа, их нужно загрузить в нейросеть одновременно. Если использовать PDF, есть риск превысить лимиты контекстного окна. PDF — тяжёлый формат, где, помимо текста, зашиты координаты вёрстки и шрифты. Нейросеть тратит огромную долю токенов на чтение и может «забыть» начало документа из-за нехватки памяти или выдать ложные правки, приняв перенос абзаца на следующую страницу за изменение текста.
В формате Markdown лишнего кода нет, поэтому файлы легче помещаются в память нейросети. ИИ тратит доступный объём токенов именно на аналитику: сравнивает документы и находит смысловые изменения. Например, обновлённые правила доступов, добавленные ограничения или новые пункты в договоре.
Собрать новый документ из нескольких источников
Сотрудникам часто приходится собирать новые регламенты из старых документов базы знаний. Например, руководитель отдела продаж пишет памятку для новичков: берёт стандарты общения из одного документа, а правила начисления бонусов — из другого. Или HR-специалист собирает единый чеклист по адаптации, объединяя инструкции по оформлению ДМС, заказу пропусков и настройке доступов.
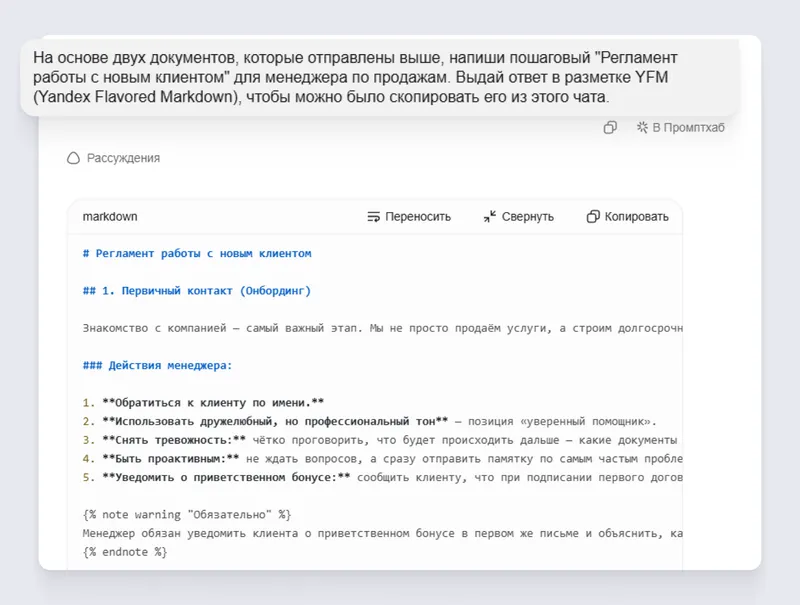
Чтобы ИИ точнее считал структуру исходников, скачайте их из Вики и загрузите в чат в формате Markdown. Лучше сразу указать в промпте формат результата. Если этого не сделать, нейросеть выдаст сплошной текст, в котором придётся вручную расставлять заголовки и собирать списки.
Попросите ИИ подготовить итоговый документ в Markdown — с заголовками, списками и таблицами. А так как готовый текст пойдёт в Яндекс Вики, в промпте можно уточнить, что вам нужна разметка YFM (Yandex Flavored Markdown). Она даёт больше возможностей для выразительности текста: например, ИИ сможет использовать специальные цветные врезки или спрятать часть инструкции под кат.
Останется просто вставить сгенерированный текст обратно в Яндекс Вики — и статья будет сразу корректно оформлена.
Листайте вправо, чтобы посмотреть, как собрать документ и выложить его в Вики.

Переходите в Яндекс Вики, скачивайте документы в формате Markdown и делегируйте анализ ИИ-ассистенту.


